「全部だめ」でも「全部いい」でもない
AI活用を検討する監理団体で、ほぼ必ず止まる場所があります。実習生の個人情報です。
さくら協同組合(架空)でも、議論は二つに割れました。一方は「実習生の情報を外部のAIに入れるのは論外だ」。もう一方は「氏名を伏せれば問題ないのでは」。どちらも一理あるのですが、この形の議論は決着しません。何を守りたいのかが、はっきりしないまま話しているからです。
現場では、もっと具体的な形で同じ問題が出ます。
- 訪問指導記録を書くのに、実習生Aさんの相談内容をAIに整理させていいのか
- 在留期限の一覧を作らせるとき、在留カード番号は渡してよいのか
- 監査報告書の起草に、受入企業の従業員構成を読ませていいのか
これらは、感覚的にも重さが違います。にもかかわらず「実習生の個人情報」という一語でまとめてしまうと、一番重いものに合わせて全部を禁止するか、一番軽いものに合わせて全部を許すか、二択になってしまいます。
必要なのは、重さの違う情報を、違うものとして扱うことです。
なぜ「個人情報」の一語では運用できないのか
監理団体が扱う情報は、性質がかなり異なるものが同居しています。
受入企業の名称や所在地は、登記でも確認できる情報です。実習生の氏名と在留期限は、団体として管理義務のある情報で、扱いは厳格ですが、書類にも記載されるものです。一方、実習生から受けた相談の中身——職場での人間関係、家族の事情、体調のこと——は、これらとまったく性質が違います。本人が団体を信頼して話した内容であり、書類に残すかどうかから慎重に判断すべきものです。
この3種類を同じ箱に入れると、どうなるか。
「個人情報だから全部だめ」とすれば、受入企業の一覧すら整理できません。効率化の話は最初の一歩で止まります。逆に「匿名化すればいい」とすれば、相談記録の中身——これは氏名を消しても本人が特定できることが多く、そもそも中身自体が守るべきもの——まで外に出すことになります。
つまり、線を引く場所を間違えているのです。線は「個人情報かどうか」ではなく、情報の性質と、渡す先の組み合わせで引く必要があります。
もう一つ重要な点があります。生成AIといっても、外部の事業者が提供するサービスに送信する場合と、団体が管理する環境の中で処理する場合では、話がまったく違います。前者は情報が組織の外に出ますが、後者は出ません。「AIに渡す」という一言が、この二つを混ぜてしまっています。
工程を3つに分ける
情報の性質と、渡す先。この二つを整理する手順です。
1. 情報を3つの階層に分ける
団体が扱う情報を、次の3階層に仕分けます。
- 第1階層:公開・準公開の情報 — 受入企業の名称、所在地、業種、様式の様式名や項目名など。外部でも確認できるか、外に出ても本人や企業に不利益が生じない情報
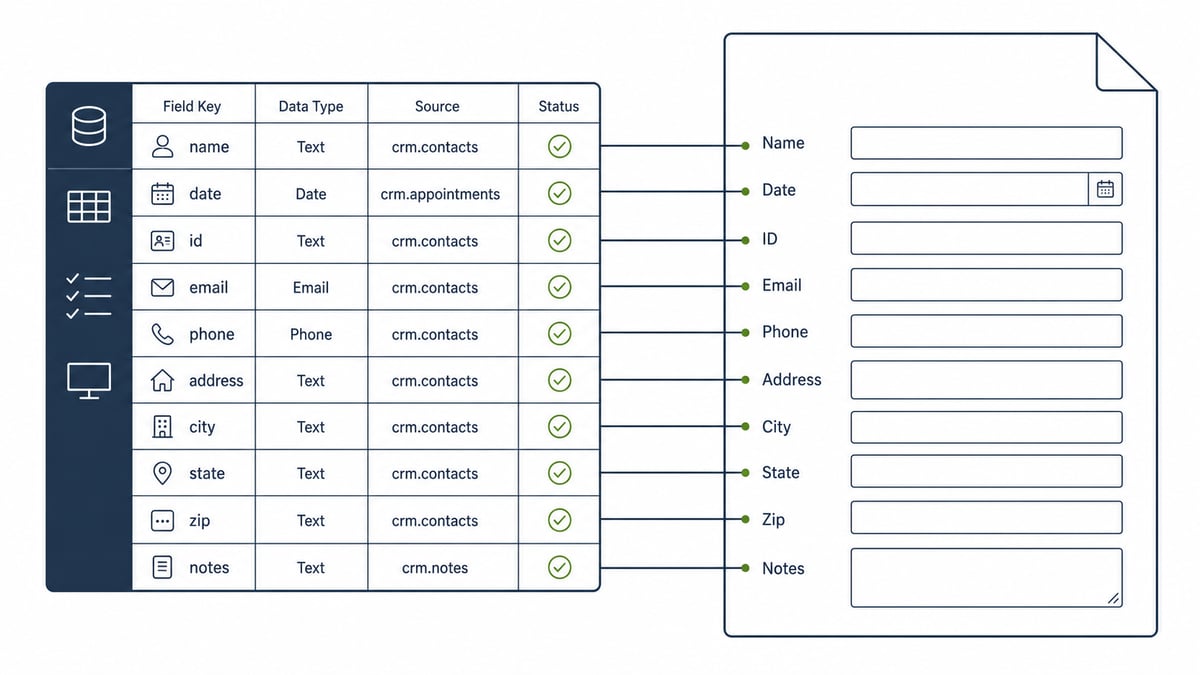
- 第2階層:管理情報 — 実習生の氏名、在留資格、在留期限、配属先、訪問日など。団体として管理義務があり、書類にも記載されるが、組織外への流出は明確に問題となる情報
- 第3階層:機微情報 — 実習生からの相談内容、健康状態、家族の事情、トラブルの経緯など。本人との信頼関係の上に成り立ち、記録に残すこと自体を慎重に判断すべき情報
この仕分けは、既存の書類を分類する作業として進めるのが現実的です。抽象的に「どんな情報があるか」を考えるより、22号関連の書類、訪問指導記録、相談記録、監査報告書を一つずつ開いて、そこに書かれている項目を3階層に振り分けるほうが早く、漏れも少なくなります。
実際にやってみると、多くの書類が第1階層と第2階層で構成されていることが分かります。第3階層が集中しているのは、相談記録と、訪問指導記録の一部です。守るべき範囲は、思っているより狭いというのが、たいていの結論になります。
2. 外部の生成AIに渡さない範囲を決める
階層が分かれたら、それぞれについて「どこまで、どの環境で扱うか」を決めます。
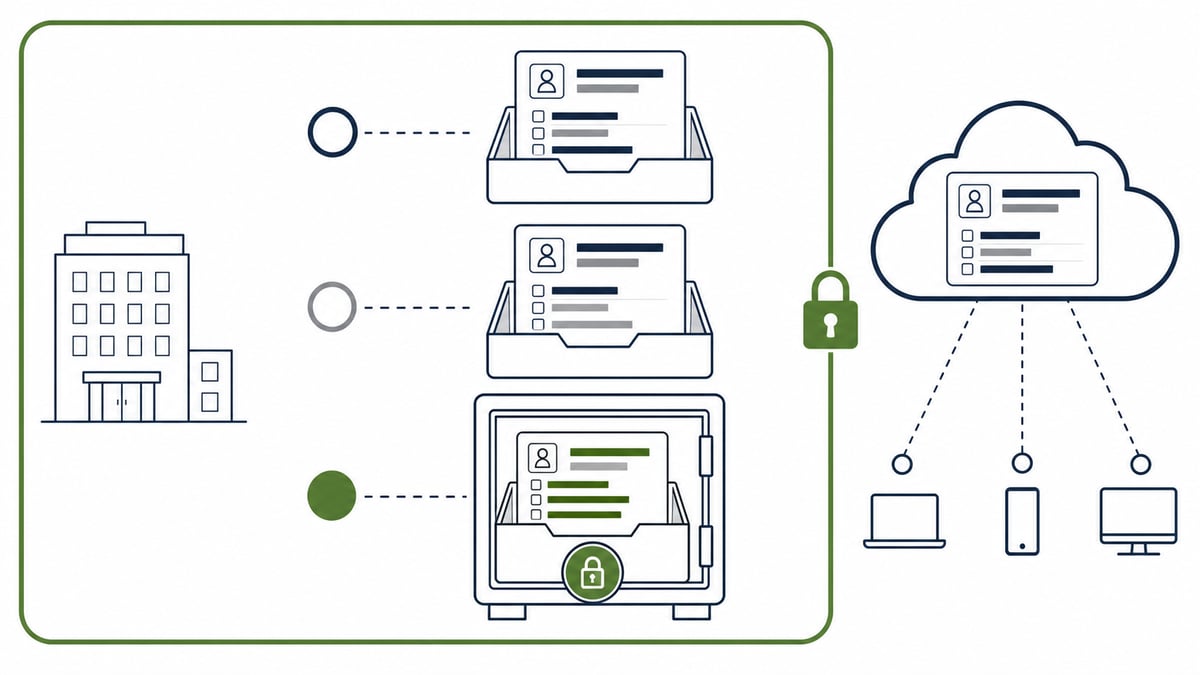
判断の軸は、その情報が組織の外に出るかどうかです。外部事業者のサービスに送信すれば、情報は組織の外に出ます。団体が管理する環境の中で処理が完結するなら、出ません。同じ「AIを使う」でも、この違いは決定的です。
したがって、決めるべきことは「AIを使うか使わないか」ではなく、どの階層の情報を、どの環境で扱うかという対応表です。第2階層・第3階層については、組織の外に出ない形で扱うのが原則になります。
ここを決めておくと、現場で迷いがなくなります。「この情報はAIに入れていいのか」と毎回考えるのではなく、「この情報は第2階層だから、こちらの環境で扱う」と機械的に決まります。判断を現場から取り上げて、事前の設計に移すことが目的です。
3. 保存場所を先に決める
三つ目は、意外と見落とされる工程です。AIが作った下書きや中間データが、どこに残るかを決めます。
書類を作る過程では、下書き、修正前の版、参照した情報の抜粋など、元の書類以外のデータが生まれます。これらが管理外の場所に散らばると、せっかく階層を分けても意味がありません。個人の端末のダウンロードフォルダに訪問指導記録の下書きが残っている、という状態は、実務上よく起きます。
そこで、書類の保存場所を先に決め、そこ以外に出ない形にします。どの階層の情報がどこに保存されるか、誰がアクセスできるか、いつまで残すかを、AIを使い始める前に決めておきます。
これは技術的な設定である以上に、団体としての情報管理の方針を、先に文書にしておくという話です。監査で問われたとき、あるいは実習生本人から問われたときに、「こう決めて、こう運用しています」と答えられる状態を作ります。
AIがやること、人がやること
境界線を明確にします。
AIに任せられること
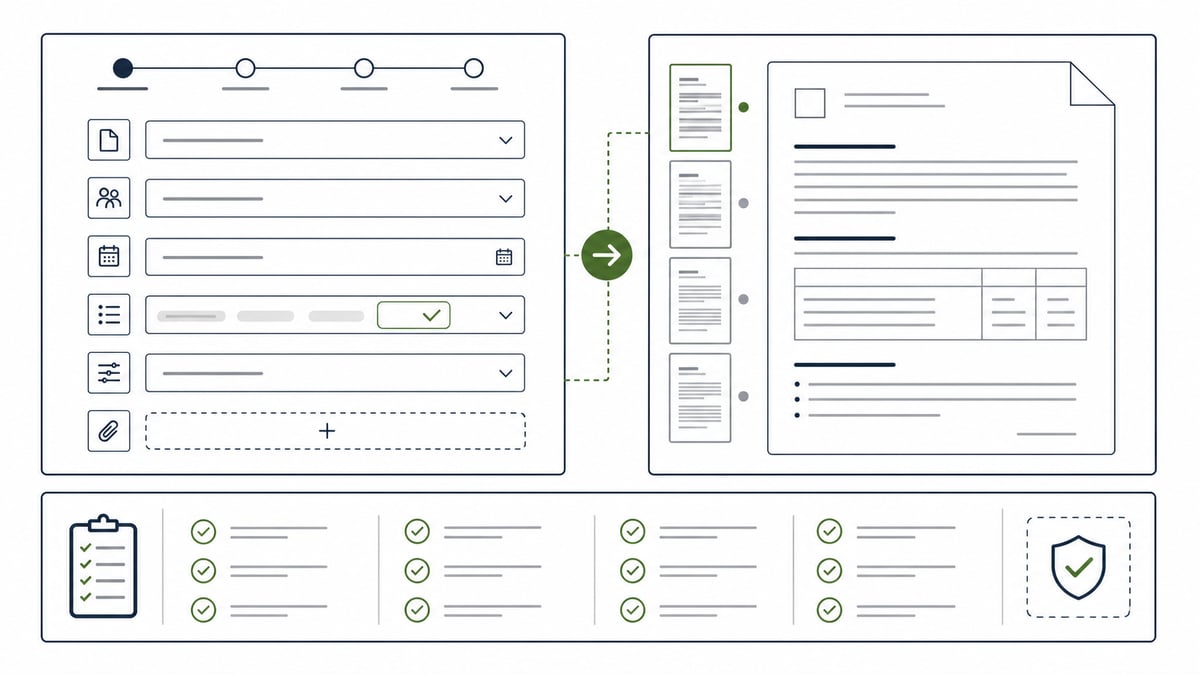
- 第1階層・第2階層の情報を、様式の該当欄に埋める — 受入企業名、実習生の氏名、在留期限、配属先といった、すでに登録されている情報を該当箇所に流し込む
- 期限や日付を突き合わせて、抜けを示す — 在留期限が近い実習生、届出の期日が迫っているものを機械的に洗い出す
- 記録の形式を整える — 訪問時のメモを、記録として読める文体に整える。ただし、中身の取捨選択は行わない
- 過去の記載との差分を並べる — 前回の訪問指導記録と今回で、どこが変わっているかを示す
人にしかできないこと
- 相談内容のうち、何を記録に残すかを決める — 実習生Aさんから受けた相談のうち、どこまでを訪問指導記録に書き、どこからを別の扱いにするか。これは本人との関係と、団体としての判断の上に成り立つものです。AIが「要約」できる種類の作業ではありません
- 本人に不利益が及ばないかを見極める — 記録に残した内容が、受入企業に共有されたとき、本人にどう跳ね返るか。株式会社サンプル製作所(架空)との関係、Aさんの立場、これまでの経緯を知っている人にしか判断できません
- 第3階層の情報を扱う判断そのもの — そもそもこの相談を記録にするのか、口頭での報告にとどめるのか。この判断は、仕組みの外側にあります
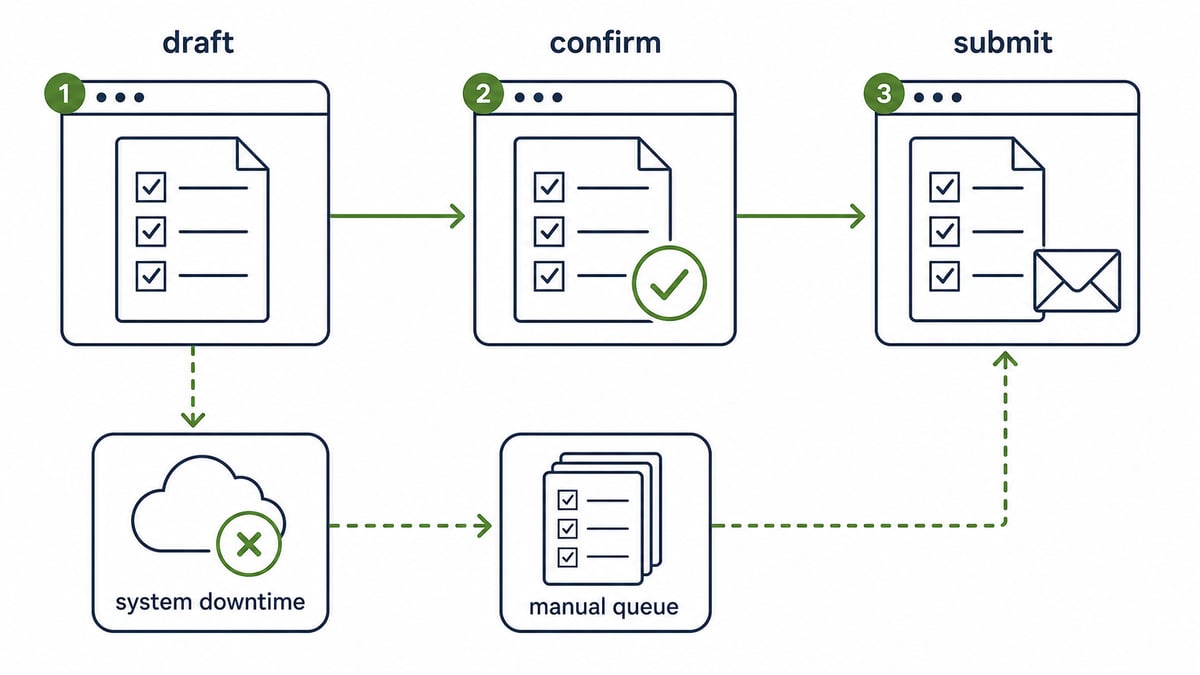
- 確定させ、提出する — 内容を確認し、これで出すと決める
ここでも、確定と提出は人が行います。個人情報の扱いにおいては、この原則はさらに重い意味を持ちます。書類に何が書かれているかを最終的に確認するのは、その内容が誰にどう伝わるかを理解している人でなければならないからです。
AIは、第3階層の情報について判断しません。判断できないのではなく、判断の対象にしない、という設計です。相談の重さを測ることは、監理団体の職員の仕事であって、道具の仕事ではありません。
線を引いてから、使い始める
「実習生の個人情報を、AIにどこまで渡していいか」への答えは、階層と環境の組み合わせで決まります。
第1階層は柔軟に扱えます。第2階層は、組織の外に出さない環境で扱います。第3階層は、そもそもAIによる処理の対象にせず、人が扱います。この線を先に引いてから使い始めれば、現場で毎回迷うことはなくなります。
逆に、線を引かずに使い始めると、「便利だから」という理由で少しずつ範囲が広がります。そして広がったことに、誰も気づかない。これが一番避けたい状態です。
Ristaは、第2階層・第3階層の情報が組織の外に出ない前提で設計しています。階層の分け方、環境の選び方、保存場所の決め方については、ウェビナーで実際の画面を交えて説明しています。理事会での説明材料が必要な方にも参加いただいていますので、詳しくはウェビナーでご確認ください。